引子
最近有了一个从大量json数据中做查询的一个需求,期间设想了多个方案,最后通过数据库查询这种还算优雅的方式解决了,记录一下。
写在前面
本篇通过具体案例来进行演示,其中数据源是大量的json,且为一个相同对象的数组,目的是从这些json中做查询、筛选。当然这并不是一成不变的,数据可以是任意格式,查询也可能千奇百怪,俺希望读者也能根据俺的思路举一反三,找到优雅的解决方案。 注意:对数据操作不当可能会导致损坏,这里仅作思路参考。
俺的心路历程
刚开始得知这个需求时,最初的json很大,打开非常耗时,并且在纯文本中对json做人肉解析实在有些难了,俺的解决方案是给他整成excel之类的格式,直接用图形化筛选就好了。
json转excel
最开始俺想复杂了,俺寻思先转成csv再转成excel(个人看法:在某种程度上这csv不就是excel嘛,所以这多转了一道)。 后来经过一顿摸索,直接整了个py脚本,json转excel。这个脚本会放到后面。 对于大量的数据来说,使用excel的筛选就有点捉襟见肘了。
json转csv,csv导入数据库
上一步中间转了一道csv。突发奇想为什么不能把这个csv扔到数据库里面呢,直接用数据库查询岂不是更爽。 经过一番摸索,发现可行。 不过有一些值得注意的点: 数据的预处理 数据库的选择 数据类型 俺摸索了一番发现可行后,就草草了事结束了。实际上对于不同的数据、不同的查询方式需要进行分类讨论,这就是上面值得注意的点的由来。 数据的预处理:在从json转换成csv时数据丢失、字段对不上等问题。 数据库的选择:你的数据存在这种数据库中是否合理,对你的查询方式是不是有影响,还有是否符合你自己的查询习惯。 数据类型:数据类型会影响到数据的预处理、数据库的选择,以及查询。
俺不是一个优秀的开发者,描述可能不清晰,还请大佬谅解。
基于例子的完整演示
大体步骤
将json中对象的字段提取出来->根据字段去创建mysql数据库->将json转换为csv格式并为csv添加一个头->将csv导入到数据库中->从数据库中查询数据
环境准备
我们需要用到的内容有:mysql数据库、dbeaver(数据库连接工具)、jq(处理json的工具)
以上提到的工具win、mac、linux都有,这里仅演示linux与mac mysql建议使用docker安装
# 创建数据目录
cd ~
mkdir -p docker/mysql/data
mkdir -p docker/mysql/conf.d
cd docker
# 运行容器并挂载
docker run -d \
--name mysql-server \
-e MYSQL_ROOT_PASSWORD=123456 \
-v `pwd`/mysql/data:/var/lib/mysql \
-v `pwd`/mysql/conf.d:/etc/mysql/conf.d \
-p 3306:3306 \
mysql:8.3
dbeaver请使用社区版Download | DBeaver Community arch:
sudo pacman -S dbeaver
mac:
brew install --cask dbeaver-community
或安装包安装 jq GitHub - jqlang/jq: Command-line JSON processor arch:
sudo pacman -S jq
mac:
brew install jq
或二进制安装
提取json对象中的字段名
# 这里.[0]的意思是数组中的第一个数据,要保证所有数据都是这个类型才能用俺的方法哦
jq '.[0] | keys' path_to.json
运行后你会获得一些字段,例如:
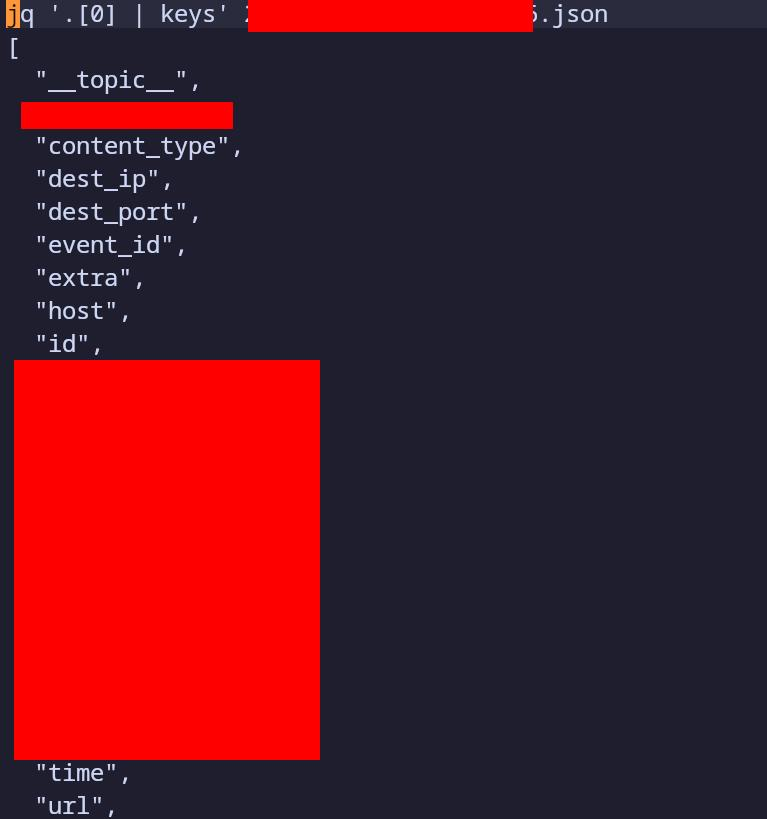 这些字段很重要,我们需要用其建表,转换json
创建mysql数据库和表
具体的创建这里就不演示了,俺觉得一些重要的的点俺要说一下。 由于我们这套流程是要使用json生成的csv去导入到数据库中,所以这里表中字段的顺序很重要。如果顺序不对,也可以另辟蹊径,在导入的时候手动一一对应,俺不推荐你这么做,建议删掉重新建表。 其次是字段的类型,类型会直接影响到导入的成功率以及查询时的优雅程度。试想对着字符串类型的数字去做筛选在某区间的值,是不是很恐怖。 俺建议对重点关注的类型去使用专门的类型,其他一些不会经常关注的类型建议使用字符型,这样会降低导入时失败的概率。
俺数据库也不太会,大佬轻喷
将json转为csv
俺这里推荐使用jq
jq -c '.[]' path_to.json | jq -r '[.column1,.column2] | @csv' > path_to.csv
原字段为column1那么jq -r '[]'中的内容应为.column1,多个字段要用,隔开
这里有个小技巧,我们如何快速的进行csv到数据库的字段一一对应呢?
可以导出一个空表,格式为csv,这样一个空的表头就会出现了
此时将空表头附加到我们转换完毕的csv开头,倒入这个新文件dbeaver就可以帮你自动对应字段啦
导入csv到数据库
这一步是出现错误最多的步骤,俺记录一下俺遇到的问题。 导入时数据类型与字段类型不匹配。解决方案:修改相关字段的类型 导入数据是为什么创建了几个没见过的字段。原因:没加表头或表头与数据不对应。解决方案:检查表头并重新附加到数据csv的开头
查询数据
将将,到了这一步就已经结束啦,愉快的查询吧。
json转excel脚本
import pandas as pd
import json
import os
def json2xlsx(json_file_path: str, output_file_path: str):
with open(json_file_path, 'r', encoding='utf-8') as f:
data = json.load(f)  # 如果JSON是数组格式
# 转换为DataFrame(自动展开嵌套结构)
df = pd.json_normalize(data)
# 保存为Excel(xlsx格式,优化内存)
df.to_excel(output_file_path, index=False, engine='openpyxl')
# json路径
json_dir = '.'
# 输出路径
output_dir = '.'
for file in os.listdir(json_dir):
if file.endswith('.json'):
json_file = os.path.join(json_dir, file)
output_file = os.path.join(output_dir, file).replace('.json', '.xlsx')
print("输出文件为: ", output_file)
print("正在转换...")
json2xlsx(json_file, output_file)
print("转换成功...")
后记
朋友在推荐了一个github项目,可以更优雅地做查询。
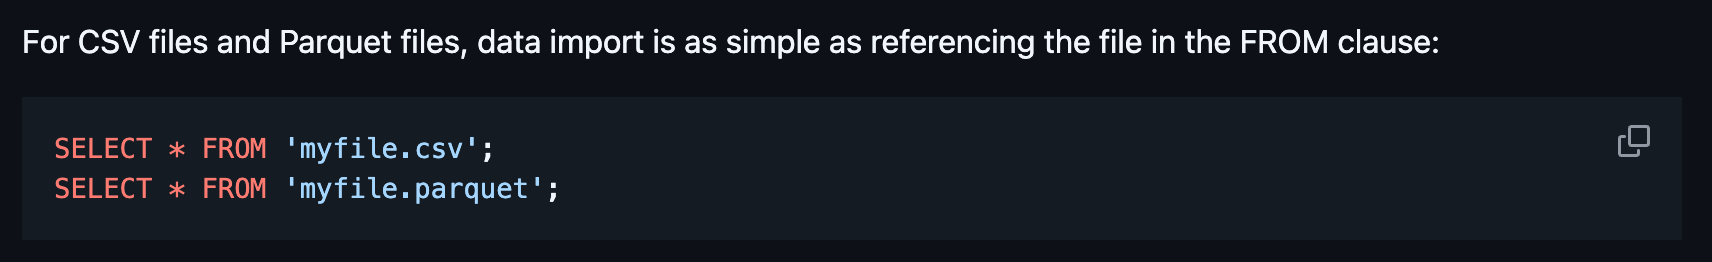 GitHub - duckdb/duckdb: DuckDB is an analytical in-process SQL database management system